

깃허브 코파일럿, 윈도우서 로컬 모델 쓴다…기기용이 터미널 평가서 클라우드판 앞질렀다
작성일
코파일럿이 로컬·클라우드 AI를 자동 배분, 로컬 코딩 모델은 53GB로 80% 축소
서피스 랩톱 울트라 대상, CLI는 Ollama 탐색 지원…로컬 선택해도 오프라인 아냐
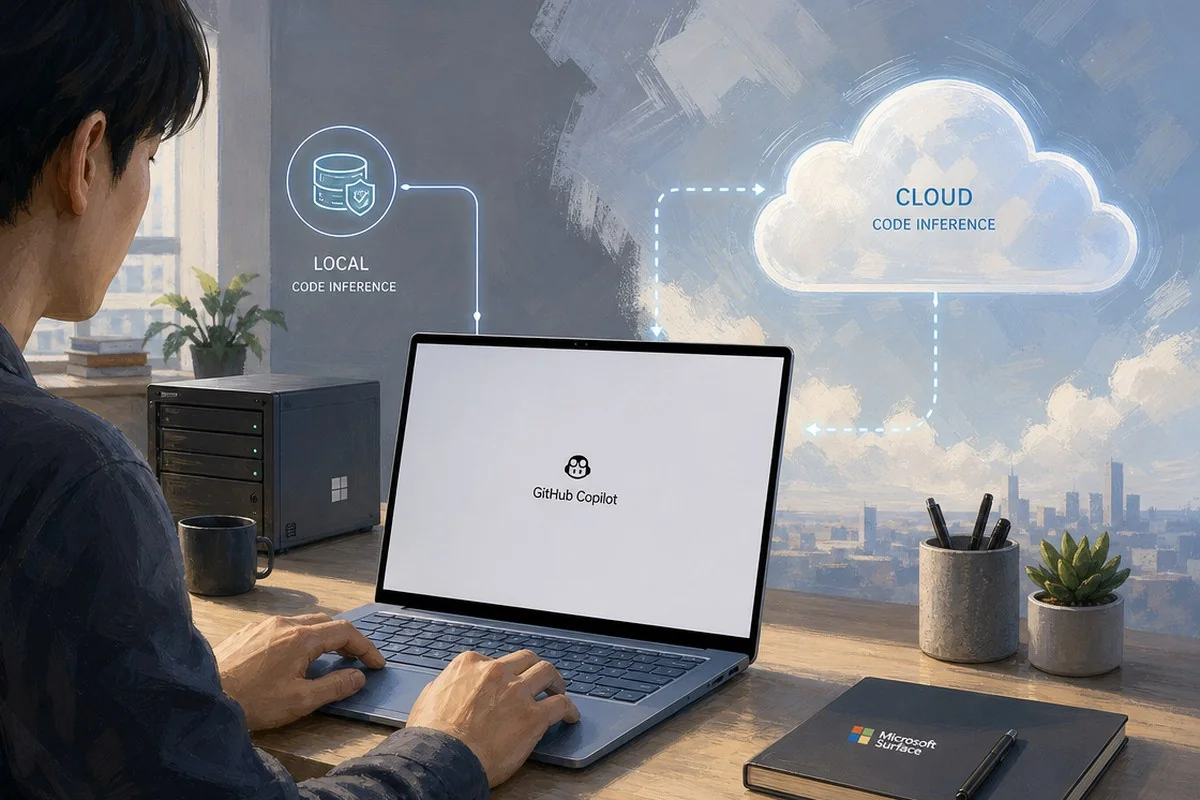
깃허브 코파일럿(GitHub Copilot)이 작업마다 기기 안에서 처리할지 클라우드 모델에 맡길지를 스스로 판단하는 기능을 선보인다. 마이크로소프트 커맨드 라인 블로그는 이달 말까지 이 기능이 들어온다고 밝혔다. 엔비디아 RTX Spark를 탑재한 윈도우 PC가 첫 대상이고 서피스 랩톱 울트라(Surface Laptop Ultra)가 대표 기기로 소개됐다.
마이크로소프트 AI가 이 기기용으로 만든 로컬 코딩 모델 ‘MAI Code 1.1 Flash’도 함께 공개됐다. 깃허브는 별도 변경 기록(changelog)을 통해 코파일럿 CLI에서 로컬 모델을 찾아 쓰는 방법도 안내했다.
개발자가 인프라를 고민하지 않도록, 코파일럿이 로컬과 클라우드를 조율
마이크로소프트는 에이전트(스스로 도구를 써 작업을 수행하는 AI)를 쓰는 개발자에게 선택권과 통제권이 모두 필요하다고 설명했다. 작업마다 속도·성능·비용 조건이 맞는 모델을 쉽게 고르고 에이전트가 움직일 범위도 분명히 정해야 한다는 취지다. 깃허브는 주요 모델 제공사의 최신 모델과 함께 ‘프로젝트 히드라퓨전(Project HydraFusion)’을 제공한다. 작업마다 하나 또는 여러 모델을 골라 성능·비용·지연 시간의 균형을 맞추는 오케스트레이터(조율 장치)다.
발표는 히드라퓨전 구상의 다음 단계로 소개됐다. 여러 모델뿐 아니라 엣지(사용자 기기 쪽)를 포함한 여러 컴퓨팅 환경에 걸쳐 지능적으로 작업을 배분한다는 것이다. 개발자가 인프라 결정을 직접 관리하지 않아도 코파일럿이 뒤에서 로컬과 클라우드 추론을 자동으로 맞춘다.
보안 장치도 같이 언급됐다. 윈도우는 대화형과 비대화형 에이전트 코딩 세션을 보호하기 위해 마이크로소프트 실행 컨테이너(Microsoft Execution Containers·MXC)를 개발했다. 코파일럿은 이런 환경에서 명령을 실행할 수 있고 파일·네트워크·시스템 기능·자격 증명에 대한 접근은 통제된다.
로컬 모델을 쓰는 방법은 두 가지다. 코파일럿 CLI와 코파일럿 앱, VS Code에서 코파일럿의 ‘Auto’ 오케스트레이션이 로컬과 클라우드를 고르게 하거나 워크플로에 직접 통제가 필요하면 로컬 모델을 명시적으로 선택하는 방식이다. Auto는 여러 턴(주고받기)에 걸친 세션에서 작업 맥락과 캐시 상태를 고려해 작업을 배분한다. 쓸모 있는 캐시 작업을 보존하기 위해서다.
메모리 예산이 관건…서피스 랩톱 울트라는 최대 128GB 통합 메모리
서피스 랩톱 울트라는 엔비디아 RTX Spark를 기반으로 하며 최대 128GB 통합 메모리와 최대 1페타플롭(petaflop)의 AI 연산 성능을 갖췄다. 통합 메모리는 CPU와 GPU가 하나의 물리 메모리 풀을 함께 쓰는 구조다. 별도 GPU를 쓰면 전용 비디오 메모리가 제약이 되고 시스템 메모리와 GPU 사이로 모델 데이터를 옮길 때 부담도 생긴다.
다만 마이크로소프트는 통합 메모리가 작업에 쓸 수 있는 용량을 늘려도 전부를 모델 가중치에 쓸 수 있는 것은 아니라고 짚었다. 운영체제와 애플리케이션, 추론 런타임도 메모리가 필요하다. 모델이 이미 처리한 토큰의 어텐션 상태를 저장하는 키-값 캐시도 마찬가지다.
에이전트가 파일을 읽고 도구 결과를 받을수록 컨텍스트가 커지고 메모리 사용량과 다음 요청 처리 부담도 늘어난다. 모델을 요청 사이에 계속 올려 두면 반복 로딩은 줄지만 응답 시간이 일정하다는 보장은 없다. 마이크로소프트는 모델이 메모리에 들어가느냐보다 코딩 작업 전체에서 어떻게 동작하느냐가 핵심 질문이라고 설명했다.
MAI Code 1.1 Flash, 1,370억 파라미터를 53GB로 줄였다
MAI Code 1.1 Flash는 코딩에 최적화한 전문가 혼합(MoE·입력마다 일부 전문가 영역만 활성화하는 구조) 모델이다. 전체 파라미터는 1,370억 개이고 활성 파라미터는 68억 개다. 온디바이스(기기 내) 버전에는 양자화(가중치 표현 정밀도를 낮춰 메모리를 줄이는 기법)와 추측 디코딩(작은 초안 모델이 토큰 묶음을 제안하면 본 모델이 검증하는 방식)이 적용됐다.
기기에서 쓰는 양자화 버전은 53GB로 클라우드의 Bfloat16 버전보다 크기가 80% 줄었다. 256k 컨텍스트에서 최대 메모리 사용량은 75.5GB다. 64k와 128k 컨텍스트의 프롬프트 처리 속도는 초당 각각 923.5토큰, 769.8토큰으로 제시됐다.
벤치마크에서 SWE-Bench Verified(데이터셋 500건)는 클라우드판이 72.6%이고 기기용 양자화 버전이 70.80%다. 비교 대상인 GPT OSS 120B는 32.0%였다. 터미널 작업 평가인 Terminal-Bench 2.1(89건)에서는 클라우드판 62.9%, 기기용 66.29%, GPT OSS 120B 23.6%다. 비교에 쓴 GPT OSS는 언슬로스(Unsloth)의 GPT-OSS-120B GGUF 버전이다.
테스트는 10월 5일(현지시각)에 진행됐다. 가중치당 약 3.3비트의 혼합 정밀도 양자화와 DFlash2 슬라이딩 윈도 추측 디코딩, 윈도우 ARM64용 llama.cpp CUDA 런타임을 썼다. 마이크로소프트는 결과가 기기와 구성 등에 따라 달라질 수 있다고 밝혔다.
마이크로소프트는 코드는 조금만 틀려도 구문 오류나 잘못된 식별자, 깨진 도구 호출로 이어질 수 있다고 설명했다. 양자화 모델은 메모리 절감뿐 아니라 작업 성공률로 평가해야 한다는 이유다.
CLI에서는 Ollama 모델 탐색…로컬 선택이 오프라인은 아니다
깃허브는 코파일럿 CLI 1.0.94-0 버전부터 /model 명령으로 실행 중인 로컬 Ollama 인스턴스의 지원 모델을 찾아볼 수 있다고 밝혔다. 이미 설정한 모델과 코파일럿이 제공하는 클라우드 모델이 목록에 함께 뜬다. 탐색됐다고 모델이 자동 추가되지는 않는다. 사용자가 모델의 제공자와 엔드포인트를 확인한 뒤 ‘Add and use for this session’ 또는 ‘Add without switching’을 골라야 한다.
CLI를 재시작하지 않고 현재 세션에서 바로 쓸 수 있다. Ollama와 모델은 미리 설치돼 있어야 한다. 이 과정에서 런타임 설치나 모델 다운로드는 이뤄지지 않는다. 모델은 도구 호출과 스트리밍을 지원해야 하고 제공자 연결에 실패하면 선택 화면에 이유가 표시된다. 코파일럿 앱에서는 설정의 Model providers에서 지원 제공자를 추가한다.
보안과 프라이버시 면에서는 오해하기 쉬운 대목이 있다. 로컬 모델을 골라도 오프라인 모드가 켜지거나 깃허브 텔레메트리(사용 정보 수집)가 꺼지지 않는다. CLI에서 오프라인 모드는 COPILOT_OFFLINE=true로 따로 지정해야 한다. 원격 제공자는 오프라인 모드에서도 네트워크를 통해 프롬프트와 코드 맥락을 받을 수 있다.
마이크로소프트도 모델 선택과 추론, 도구 실행은 경계가 서로 다르며 로컬 추론이 세션을 오프라인으로 만들지는 않는다고 적었다. 로컬 모델을 포함한 지능형 라우팅의 제공 시기는 깃허브 변경 기록에서 추후 안내된다.