

깃허브 코파일럿 지능 티어, 크레딧 5배 써도 최저가 효율성 응답보다 품질 떨어졌다
작성일
깃허브 코파일럿 오토 모델 선택에 비용·품질 3단계 티어 신설
실측 결과 AI 크레딧 소비가 0.88~4.29로 최대 5배 차이났다
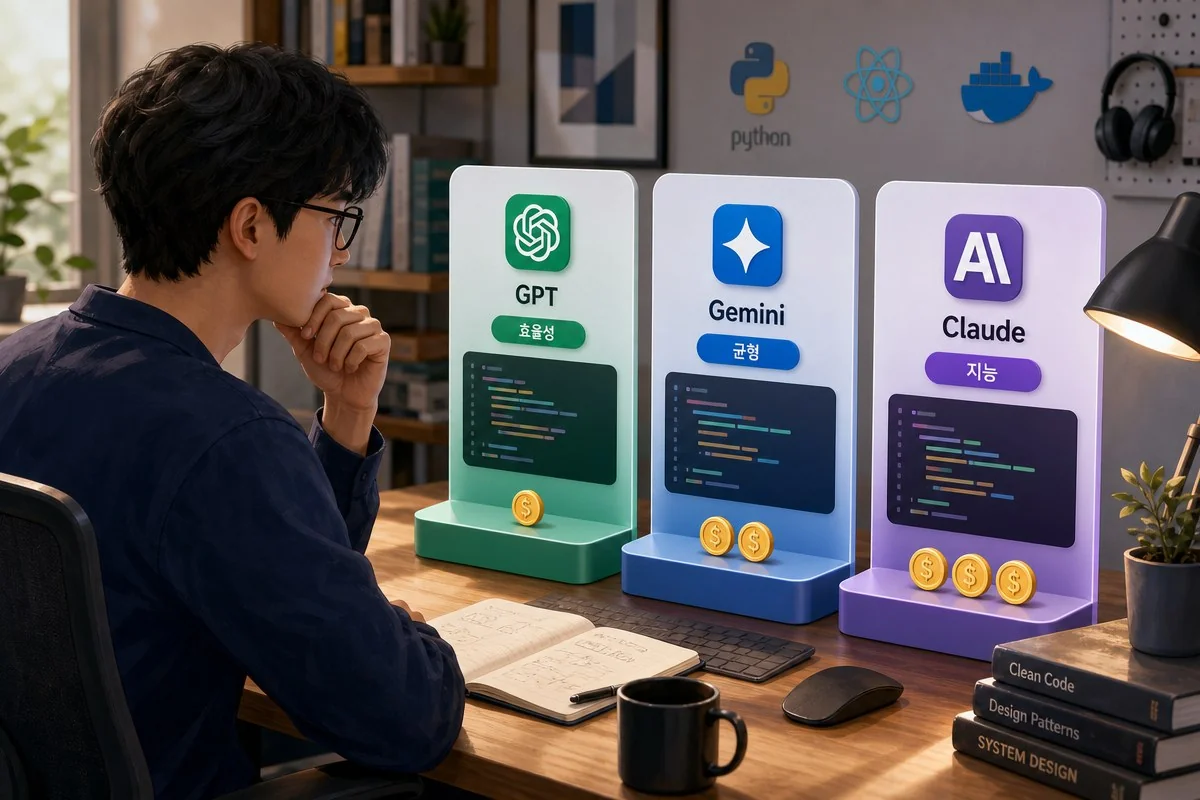
깃허브 코파일럿(GitHub Copilot)의 자동 모델 선택 기능에 비용과 품질 중 무엇을 우선할지 고르는 3단계 설정이 추가됐다. 깃허브는 9월 14일(현지시각) 공식 블로그를 통해 오토(Auto) 모델 선택에 효율성(Efficiency)·균형(Balance)·지능(Intelligence) 세 가지 티어를 도입했다고 밝혔다. 비주얼 스튜디오 매거진이 같은 프롬프트로 세 티어를 각각 테스트한 결과 지피티(GPT)-5.6 루나, 제미나이 3.7 플래시, 클로드 소넷 5로 서로 다른 모델이 선택됐고 AI 크레딧 소비량도 0.88에서 4.29까지 차이가 났다.
배경: 사용량 기반 과금 충격 이후 계속된 비용 관리 강화
깃허브는 6월 코파일럿 요금 체계를 사용량 기반 과금으로 전환하면서 많은 개발자가 예상치 못한 고액 청구서와 빠른 토큰 소진에 당황하는 사태를 겪었다. 이후 마이크로소프트와 깃허브는 비용 관리 안전장치를 꾸준히 추가해왔다. 비주얼 스튜디오 코드의 지출 미터와 세션별 사용량 표시, 비주얼 스튜디오의 사용량 경고, 깃허브의 세분화된 AI 크레딧 예산·리포팅 기능 등이 이런 흐름 속에 나왔다.
새로 도입된 오토 티어는 사용량을 보여주고 제한하는 수준을 넘어, 코파일럿이 애초에 어떤 모델을 선택할지에 직접 영향을 주는 단계로 나아간 조치다. 깃허브는 “이는 모델 선택 방식을 사용자가 직접 맞추고, 그 과정에서 어떤 트레이드오프를 감수하는지 더 잘 보여주기 위한 여정의 첫걸음”이라고 밝혔다.
세 가지 티어, 무엇이 다른가
깃허브가 설명한 세 티어의 성격은 뚜렷이 구분된다. 효율성은 비용을 낮게 유지하는 데 초점을 맞춰 빠르고 단순한 작업에 적합하다. 균형은 비용·품질·응답 속도를 함께 고려해 일상적인 작업에 알맞다. 지능은 품질을 우선해 복잡한 작업을 겨냥한다.
다만 세 티어가 서로 다른 모델 풀을 쓰는 것은 아니다. 깃허브는 세 티어 모두 동일한 모델 집합에서 선택하며, 오토 기능이 프롬프트마다 개별적으로 평가해 사용자가 정한 비용-품질 설정 안에서 가장 적합한 모델을 고른다고 설명했다. 지능 티어를 선택해도 모든 요청이 더 비싼 모델로 가는 것은 아니다. 예를 들어 기존 함수에 문서화 주석을 추가하는 단순 작업이라면 지능 티어에서도 작고 효율적인 모델로 처리될 수 있다.
새 기능은 비주얼 스튜디오 코드, 코파일럿 CLI, 깃허브 코파일럿 앱에 순차 적용되고 있다. 과금은 선택한 티어가 아니라 오토가 실제로 골라준 모델을 기준으로 부과되며, 유료 구독자는 오토 선택을 통한 사용량에 계속 10% 할인을 받는다.
실측해보니: 같은 프롬프트인데 모델도 비용도 제각각
비주얼 스튜디오 매거진은 깃허브 코파일럿 앱에서 매번 새 세션을 열고 오토 최적화 설정만 바꿔 동일한 프롬프트를 세 차례 제출했다. 프롬프트는 씨샵 클래스 하나를 동시성·비동기 처리 문제 관점에서 점검하고, 공개 API를 유지하면서 같은 키에 대한 중복 작업을 막고 취소 처리를 올바르게 하고 성공한 결과는 5분간 캐시하되 실패나 취소는 캐시하지 않는 수정판을 만들어 달라는 내용이었다.
결과는 티어 이름이 시사하는 방향대로 나타났다. 효율성 티어는 지피티-5.6 루나를 선택했고 약 30초 만에 0.88 AI 크레딧을 소비했다. 균형 티어는 제미나이 3.7 플래시를 골랐고 약 29초에 2.01 크레딧을 썼다. 지능 티어는 클로드 소넷 5를 선택했으며 11초 만에 응답했지만 4.29 크레딧을 소비했다. 지능 티어의 크레딧 소비량은 효율성 티어의 거의 5배에 달했다.
다만 이 결과를 통제된 벤치마크로 받아들이기는 어렵다. 세 요청의 컨텍스트 캐시 상태부터 달랐다. 효율성 요청은 캐시가 새로 구축됐고 균형 요청은 캐시되지 않았으며 지능 요청은 컨텍스트의 73%가 캐시된 상태였다. 모델별로 출력량도 다소 차이가 났고 가격 정책·토큰화 방식·서비스 부하 같은 변수도 크레딧 소비와 응답 시간에 영향을 줄 수 있다. 깃허브 스스로도 오토가 프롬프트마다 개별 평가를 거치는 만큼 같은 실험을 반복해도 동일한 모델이 선택된다는 보장은 없다고 설명한다.
비용을 더 써도 품질이 보장되지는 않는다
비용과 결과물 품질의 관계도 단순하지 않았다. 비주얼 스튜디오 매거진은 자체 코딩 지식이 없어 회사에서 쓰는 챗GPT에 프롬프트 설계와 세 응답 평가를 맡겼다. 챗GPT는 가장 저렴한 효율성 티어의 지피티-5.6 루나 응답을 핵심 요구사항을 가장 잘 구현한 결과로 평가했다. 가장 비싼 지능 티어가 반드시 가장 나은 코드를 내놓는 것은 아니라는 뜻이다.
이런 결과는 개발자들이 티어를 고를 때 참고할 만한 지점이다. 복잡한 작업이라고 무조건 지능 티어를 선택하기보다, 실제 작업 난이도와 예산에 맞춰 효율성·균형 티어를 먼저 시도해볼 여지가 있다. 깃허브가 이번 조치를 “모델 선택을 사용자화하는 여정의 첫걸음”이라고 표현한 만큼, 앞으로 티어별 세부 조정 기능이 추가로 나올 가능성도 있다.